进入 2021 年才五天,OpenAI 就扔出了一颗不大不小的信号弹。1 月 5 日,这家在 2020 年凭 GPT-3 搅动整个人工智能圈子的实验室,同时公布了两个看起来不太起眼、却被我反复翻看的模型:一个叫 DALL·E,一个叫 CLIP。前者能根据一句自然语言描述直接生成图像,后者则让机器第一次像人那样把“图片”和“文字”对应起来。两篇技术博客不长,但连起来读,你会发现人工智能正在悄悄翻过一座山——从“只会读写文本”,走向“能同时理解图像和语言”。作为常年跟踪模型演进的从业者,我觉得有必要在年初就把这件事说清楚。
一、DALL·E:把 GPT-3 的语言能力搬到像素上
DALL·E 这个名字取自画家达利与皮克斯机器人瓦力的合体,听着玩闹,背后的思路却很直接。OpenAI 把它描述成一个 120 亿参数的 GPT-3 变体,用大量“文本—图像”配对数据训练,学会的是一件以前很难做好的事:你给它一句话,比如“一个穿芭蕾舞裙的小萝卜在遛狗”,它就直接吐出一张对应的图。
关键不在于它画得像不像照片,而在于它理解了语言里的组合关系。官方演示里,它能把毫不相关的两个概念拼到一起并且看起来合理,能把动物和物体拟人化,能在画面里写出准确的文字,还能按指令对已有图像做局部变换。这说明它学到的不是“图像库检索”,而是一种把句子拆解成视觉要素、再重新组装的能力。对做设计、做素材、做游戏美术的人来说,这种“一句话出图”的想象空间,怎么形容都不夸张。
从技术实现看,它的做法并不神秘:先用一个视觉编码网络把图像切分成一串离散的“视觉标记”,再把文字和这串视觉标记拼在一起,交给一个自回归 transformer 像接龙一样逐个预测。换句话说,生成图像对它而言和续写一句话几乎是同一类问题。这种“把一切都序列化成 token”的思路,正是 GPT-3 成功的底层逻辑,DALL·E 只是把预测对象从文字延伸到了像素。
当然也要泼点冷水。目前 DALL·E 生成的是 256×256 的小图,复杂手部、精确文字、严谨透视依然会出错,它更像一个“概念草图生成器”而不是成品工具。OpenAI 这次也只是放出演示,没有开放接口。但技术路线一旦被验证,后续沿着这条线把分辨率、真实感和可控性做上去,只是时间问题。
二、CLIP:让机器真正“看懂”图文对应关系
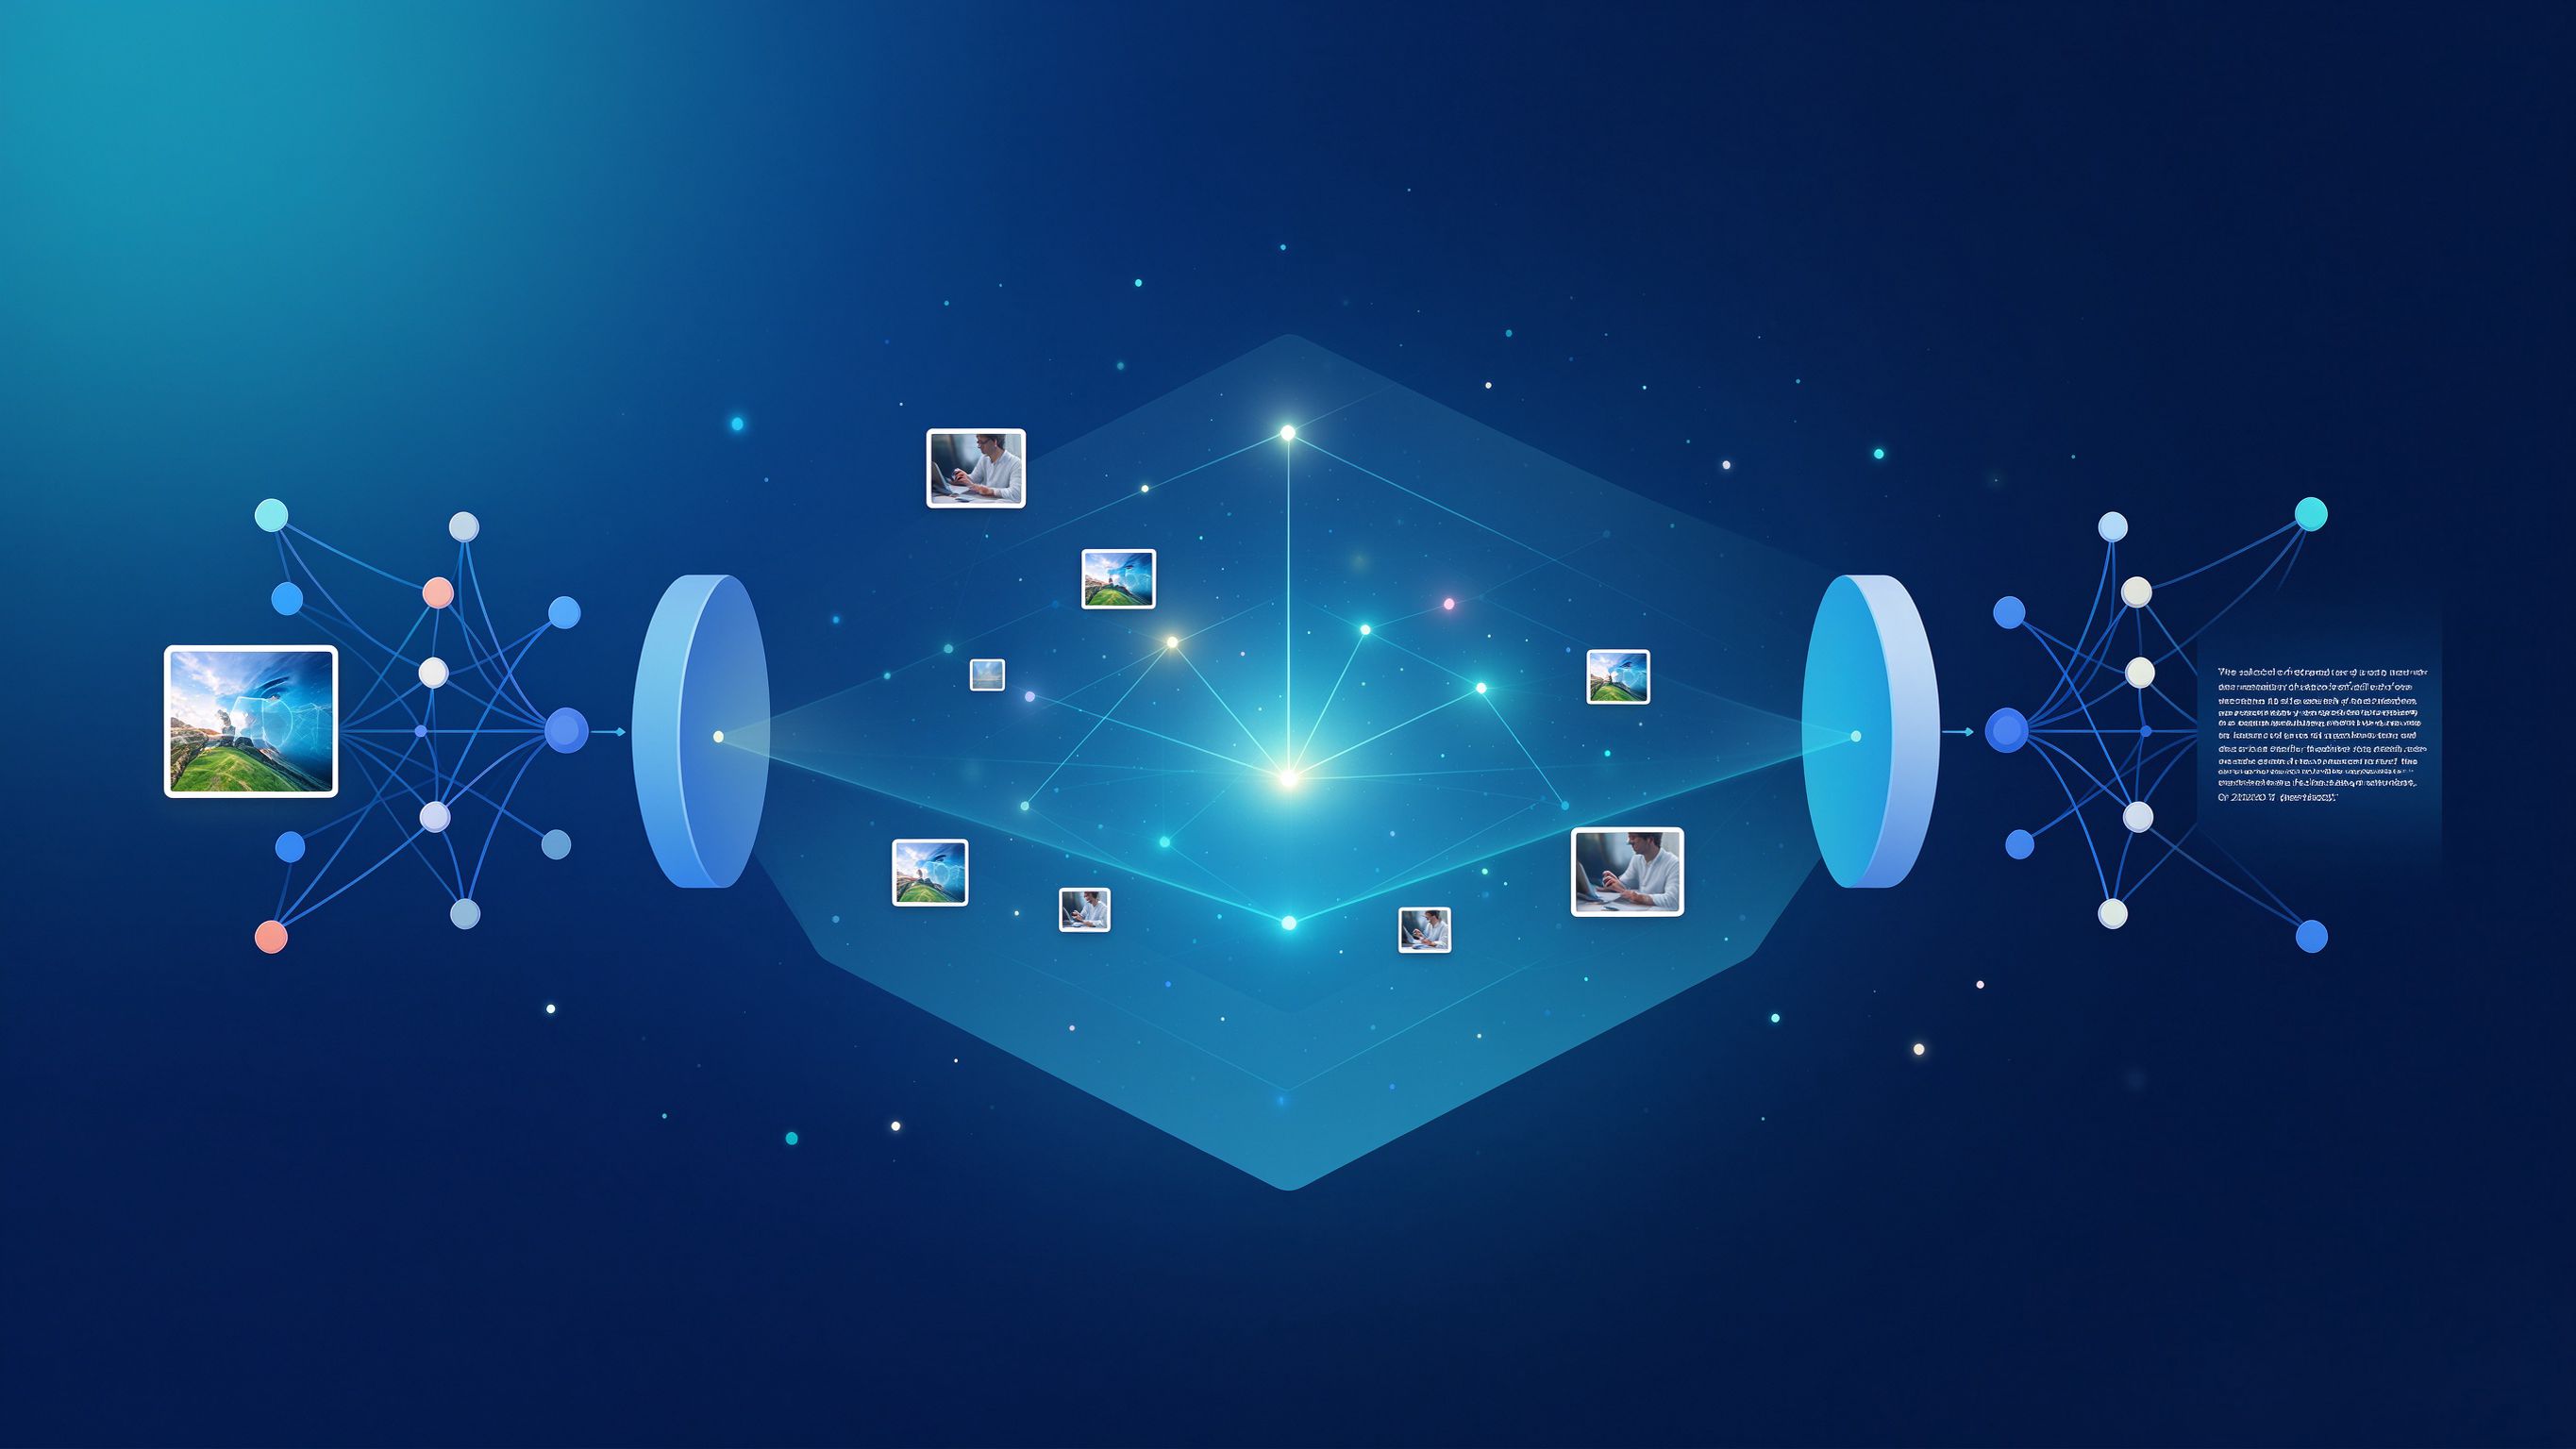
如果说 DALL·E 是“生成”的惊喜,那 CLIP 就是“理解”的底座。CLIP 的全称是对比式语言—图像预训练,做法是用大约四亿组图文配对,训练一个模型把描述同一张图的文字和图像特征拉到一起、把不相关的推远。
它最打动人的地方是“零样本”。传统图像分类模型必须先告诉你“要分哪几类”,再拿对应数据去训练;CLIP 却能直接问它“这张图里是一只狗还是一辆汽车”,它凭语言提示就能给出判断,不需要为新类别重新训练。官方在二十多个经典视觉数据集上做了测试,不少任务里它零样本的表现,居然追平甚至超过了专门训练的监督模型。这等于把图像识别从“为每个任务单独造一个模型”,变成了“靠自然语言临时定义任务”。对做搜索引擎、做内容审核、做多模态推荐的团队来说,这是范式级别的变化。
更进一步看,CLIP 还悄悄改写了“提示词”这个概念。以前你给计算机一个类别标签,现在你给它一句描述,哪怕是“一张装在木碗里、泡着牛奶的麦片,窗外是模糊的城市天际线”这种自由句子,它也能判断图像和描述是否匹配。这意味着人机交互的接口正在从“点选标签”回到“自然语言”——这和 GPT-3 带来的对话式交互其实是同一条大河的两支支流。
三、为什么这两件事放在一起才更值得说
单看 DALL·E,你会觉得它是个好玩的生成玩具;单看 CLIP,你会觉得它是个不错的识别改进。但把两者放在 2021 年初这个时间点看,信号就清晰了:模型的“通用感官”正在形成。GPT-3 证明了大规模自监督预训练能让一个模型学会通用语言能力,DALL·E 和 CLIP 则证明,同样的配方换到图像上也成立。
这意味着什么?意味着未来的模型可能不再是“一个语音模型、一个图像模型、一个文本模型”各管一段,而是一个能同时吃进文字、图片甚至更多模态的统一系统。你用一句话下指令,它既理解你的意图,又能在图像世界里执行。对开发者而言,多模态将不再是锦上添花,而是下一代产品的默认配置。国内很多团队去年就在关注跨模态检索和图文生成,这次 OpenAI 的两步棋,等于给整条路线投了一张信任票。
从产业视角再往下看一步:当“以文搜图”“以图生文”“文图互译”的成本被打下来,最先被重塑的可能是离图像最近的几个行业。广告创意可以先出概念草图再精修,电商可以用文字批量生成场景图,媒体可以自动给长篇报道配示意图,教育和游戏则能按需生产教学插画。这些不是科幻,而是今年就会有团队开始尝试的产品方向。当然,能力越强,对内容安全和审核的要求也越高——模型一旦能自由生成图像,鉴别和把关的压力会成倍转移到平台侧。
四、冷静看:离落地还有多远
兴奋之余,我更愿意把话说在前面。第一,数据与版权:四亿组图文从哪来、是否合规、训练出的图像涉及谁的知识产权,这些法律和伦理问题今年只会越来越尖锐,产品化时绕不过去。第二,可控性:现在的生成模型像是“想象力很丰富但不太听话”的实习生,你想让它精确控制构图、字体、品牌色,它往往给你一个“差不多”的结果,工业级生产流还需要额外的工程约束。第三,成本:百亿级参数的多模态模型,训练和推理都很贵,中小团队想用上,得等开源方案和算力成本进一步下降。
所以我的判断是:2021 年不会立刻出现“人人用文字出海报”的盛况,但这一年会是多模态大模型从实验室走向产品的起点。对从业者,我的建议很实在——今年就开始在自己的业务里找“图文混合”的场景,无论是素材生成、以图搜文,还是更自然的搜索框,越早积累数据和评测方法的团队,越能吃到下一波红利。
还有一个容易被忽略的点:这些模型的进步很大程度来自“规模”二字——更大的模型、更多的图文配对、更强的算力。这意味着多模态能力的竞赛,本质上是数据规模与算力的竞赛。对国内企业而言,如何在合规前提下构建高质量的中文图文数据集、如何用好国产算力,会是未来几年绕不开的功课。技术路线别人趟出来了,但真正的产品和数据护城河,还得自己一砖一瓦去垒。
语言是模型的嘴,图像是模型的眼。当 DALL·E 和 CLIP 在同一个年初亮相,人工智能真正开始睁眼看世界了——这扇门一旦打开,就不会再关上。

0 条评论
还没有评论,快来抢沙发吧!
发表评论