1950年,阿兰·图灵在《Mind》杂志上发表了一篇题为《计算机器与智能》的论文,开篇便是一个如今已经被引用到滥俗的问题:”机器能思考吗?”为了回答这个问题,他设计了著名的”图灵测试”——如果一台机器在对话中能够让人类无法分辨自己面对的是人还是机器,那么这台机器就可以被认为是”智能”的。
六十多年过去了,我们仍然在用这个问题的各种变体来追问人工智能(AI)的边界。作为一名从业多年的IT工程师,我常常觉得,与其争论”机器能否思考”这种哲学命题,不如低下头来看看这条已经走了半个多世纪的技术之路,看看我们究竟站在哪里,又是怎么走到这里的。
从达特茅斯到两次寒冬
1956年的夏天,一群年轻的科学家聚在达特茅斯学院,开了一场为期两个月的研讨会。会上,约翰·麦卡锡、马文·明斯基、克劳德·香农等人第一次使用了”人工智能”这个说法,并把目标定得雄心勃勃:让机器学会使用语言、形成抽象概念、解决人类留给它的难题。那是一个乐观的年代,与会者普遍相信,十年之内机器就能做到这些事。
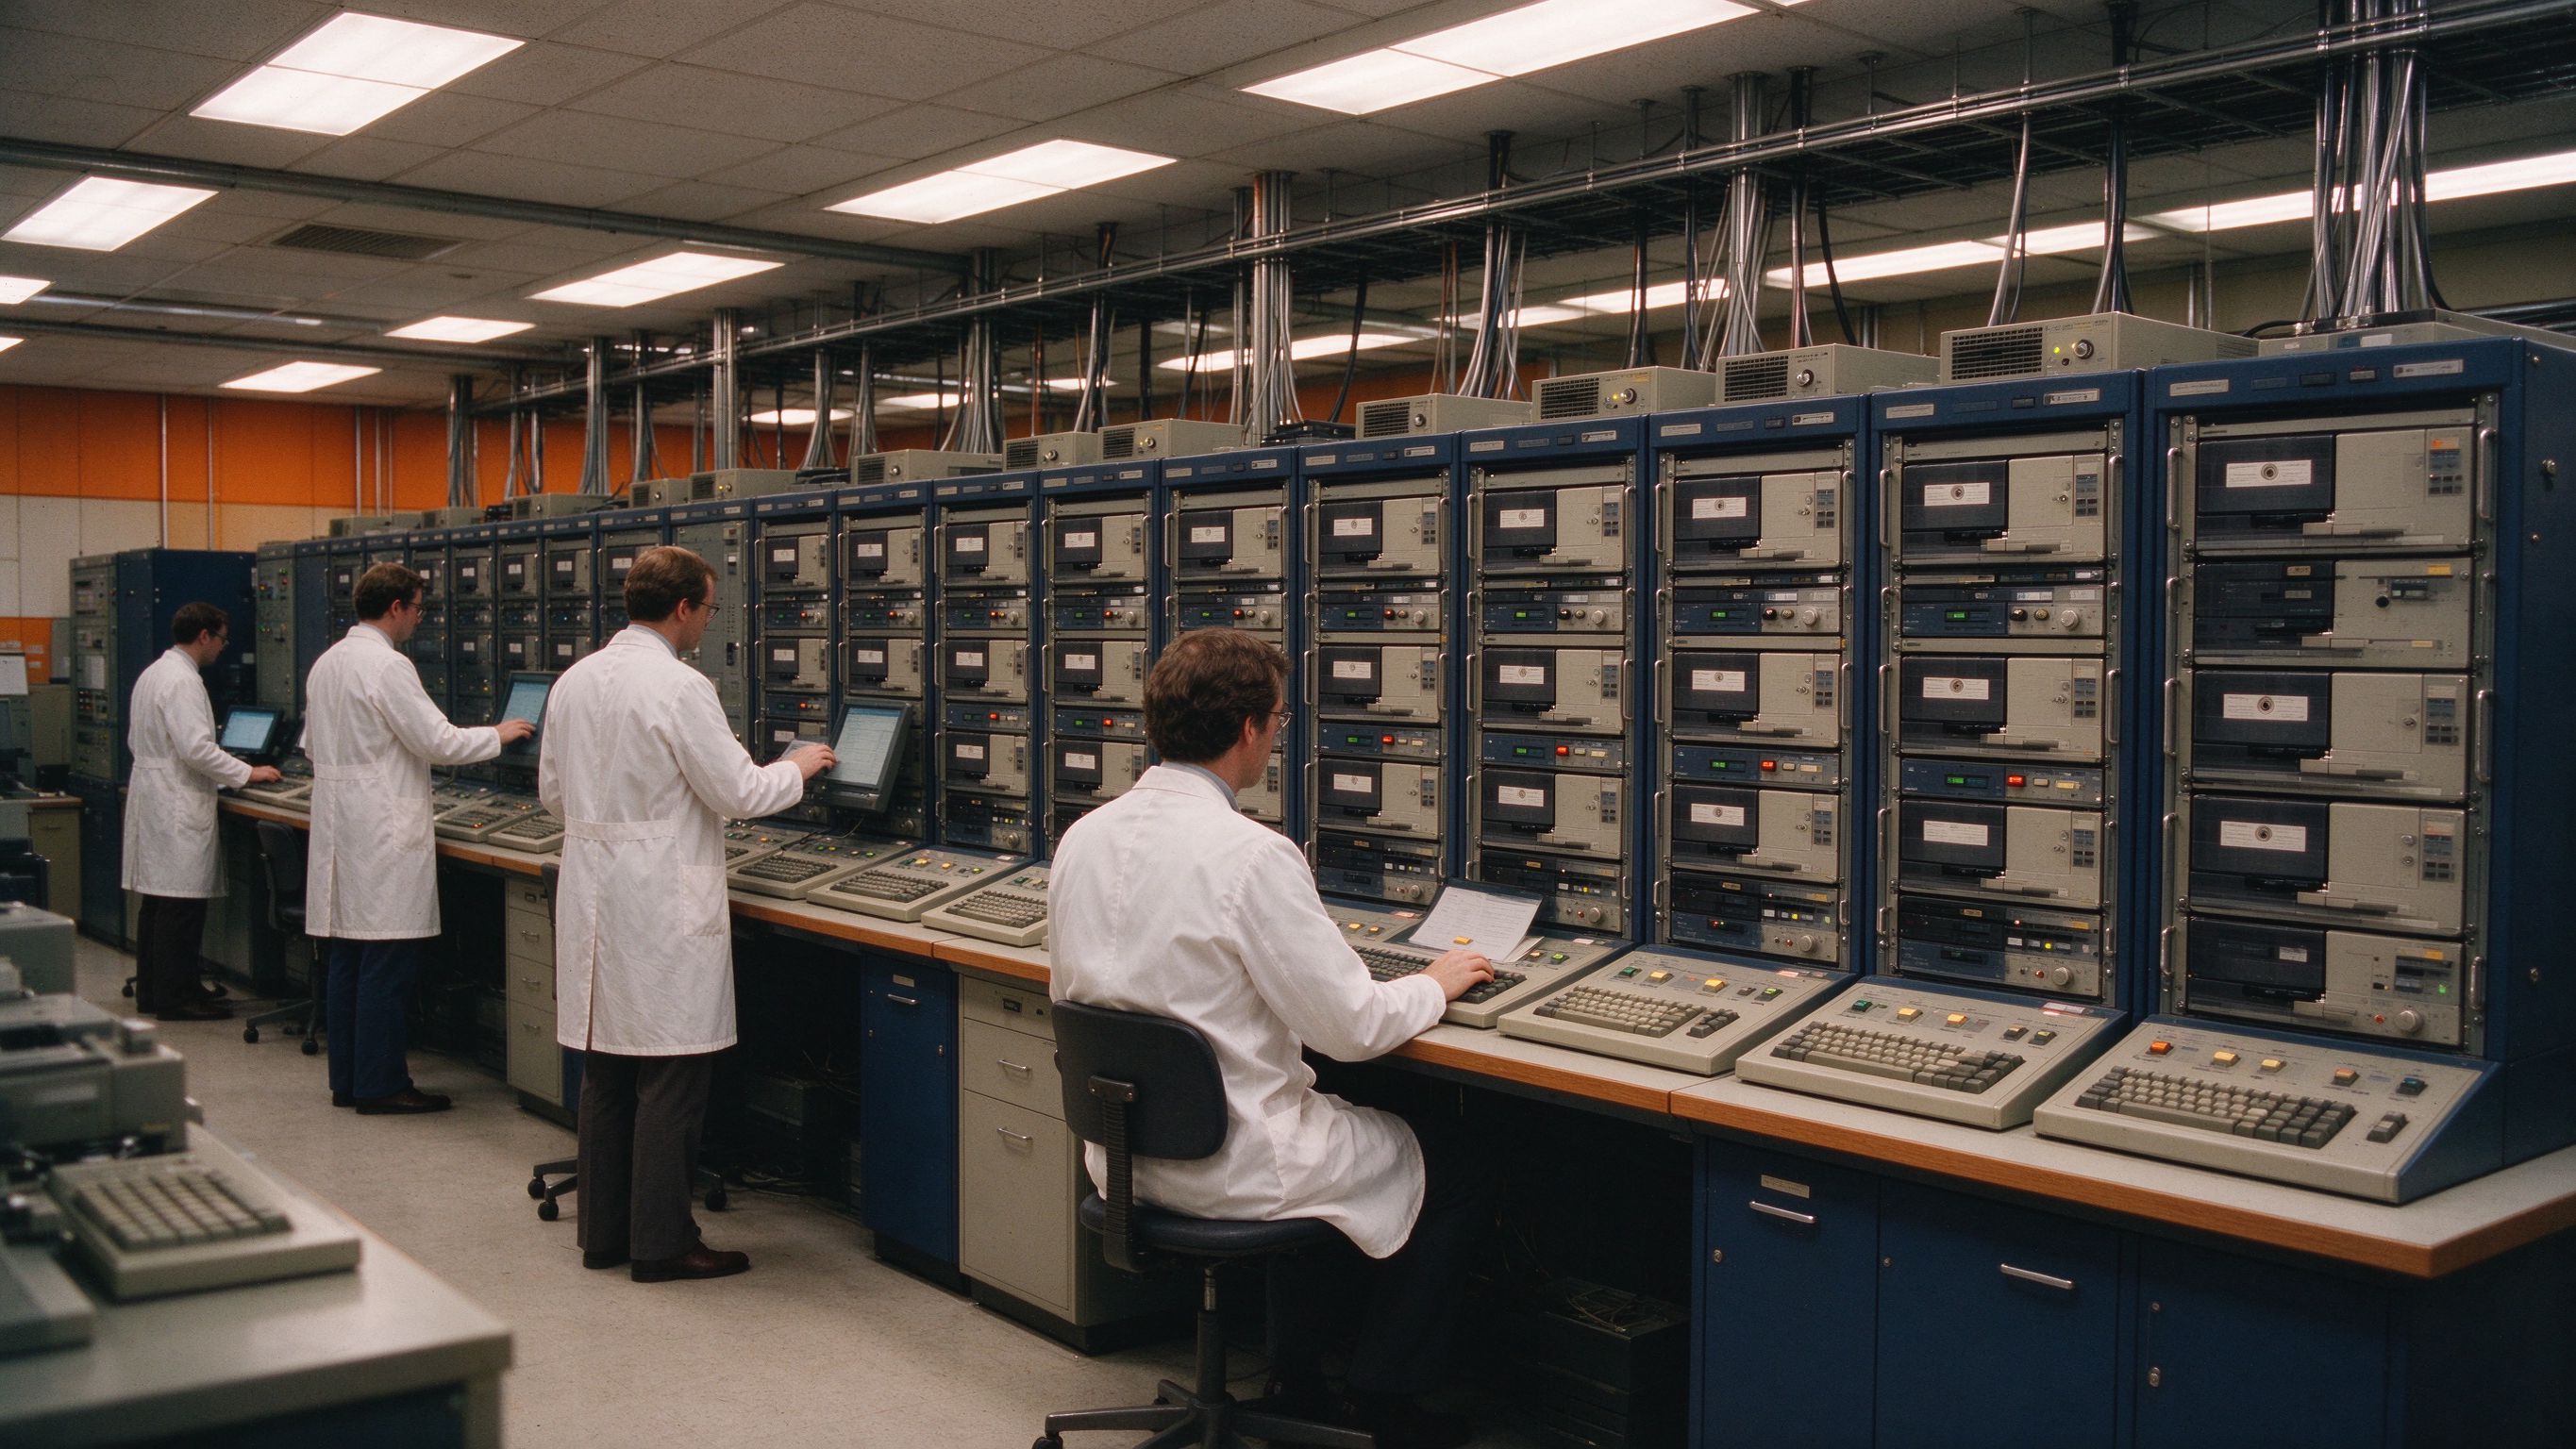
后来的事情大家都知道了。第一波热潮里,人们做出了能解微积分方程的”逻辑理论家”程序,做出了会下跳棋的程序,专家系统也开始在医疗、地质领域小试牛刀。但”智能”远比想象中复杂。机器解不出稍微复杂一点的常识问题,符号逻辑在真实世界的海量噪声面前捉襟见肘。上世纪七十年代,英国《莱特希尔报告》给AI泼了一盆冷水,美国国防部高级研究计划局(DARPA)也撤回了大部分资助——第一次AI寒冬来了。
八十年代,专家系统(Expert System)再次把AI带回舞台中央。当时日本雄心勃勃地搞”第五代计算机”计划,欧美企业纷纷跟进,规则引擎一度是银行、保险行业的标配。可惜专家系统本质上是”人类知识的手工搬运”:把专家头脑里的规则一条条写进代码,既昂贵又脆弱,一碰到规则覆盖不到的情况就全线崩溃。九十年代初,DARPA再次缩减预算,第二次寒冬降临。IBM深蓝在1997年击败国际象棋世界冠军卡斯帕罗夫,算是在寒冬尾巴上给AI界打了一针强心剂——但即便那时,也很少有人真的相信,机器能靠”学习”而不是”规则”获得智能。
转机:数据、算法与算力
真正的转机来自三个变量的同步成熟。
第一是数据。互联网把全世界的文本、图片、点击行为都变成了可用的训练素材,搜索引擎、电子商务和社交网络每天产生海量的”标注数据”。第二是算法。上世纪八十年代就提出的反向传播算法(Backpropagation)重新被捡起来,神经网络在语音识别、手写识别上开始取得超出传统方法的成绩。第三是算力。摩尔定律让普通工程师的笔记本也能跑起几百万参数的模型,而GPU——本来是给游戏准备的显卡——被发现特别适合做大规模并行矩阵运算,一夜之间成了机器学习研究者的新宠。
于是我们看到了这一轮让人兴奋的进展:2011年2月,IBM的沃森(Watson)系统在智力竞赛节目《危险边缘》(Jeopardy!)中击败两位人类冠军,它能理解自然语言问题、在毫秒级的时间里检索海量知识库并给出答案;2011年10月,苹果在iPhone 4S上推出语音助手Siri,让”人机对话”第一次走进普通人的口袋;谷歌的无人驾驶汽车已经在加州和内华达州的公路上累计行驶了数十万公里,靠的正是激光雷达、传感器和机器学习算法的实时配合。
我们站在哪里
平心而论,今天的人工智能距离”通用智能”还差得很远。机器不会聊天,只能对话;不会思考,只能搜索与匹配;不会理解,只能统计。我们做的更多是”感知”层面的突破——语音识别、图像识别、推荐系统——而”认知”层面的路还很长。
但历史告诉我们,这个领域每一次陷入低谷,都是因为人们高估了短期、低估了长期。1956年达特茅斯的那群年轻人定下的目标,六十年来一直像个遥远的灯塔。今天,当数据、算法、算力三条河流终于汇聚到一起,我倾向于认为,我们正处在人工智能又一次黄金时代的前夜。接下来的几年,会是这个领域近二十年来最值得关注的窗口期。
写在最后:技术圈里流传着一句话——”我们总是高估未来两年的变化,却低估未来十年的变化。”对于人工智能,我同样抱有这种看法。

0 条评论
还没有评论,快来抢沙发吧!
发表评论