3 月 22 日的 GTC 大会上,黄仁勋用一场几乎全虚拟形象的 keynote,发布了 NVIDIA 的新一代数据中心架构 Hopper,以及它的第一颗 GPU——H100。这颗芯片塞进了 800 亿个晶体管,是迄今为止规模最大、性能最强的加速器。黄仁勋在台上反复强调一句话:数据中心正在变成 AI 工厂。这句话听着像口号,但 H100 身上那项专门为 Transformer 模型设计的 Transformer Engine,才是这场发布真正的分量所在——它意味着,芯片行业终于开始围着大模型转了。
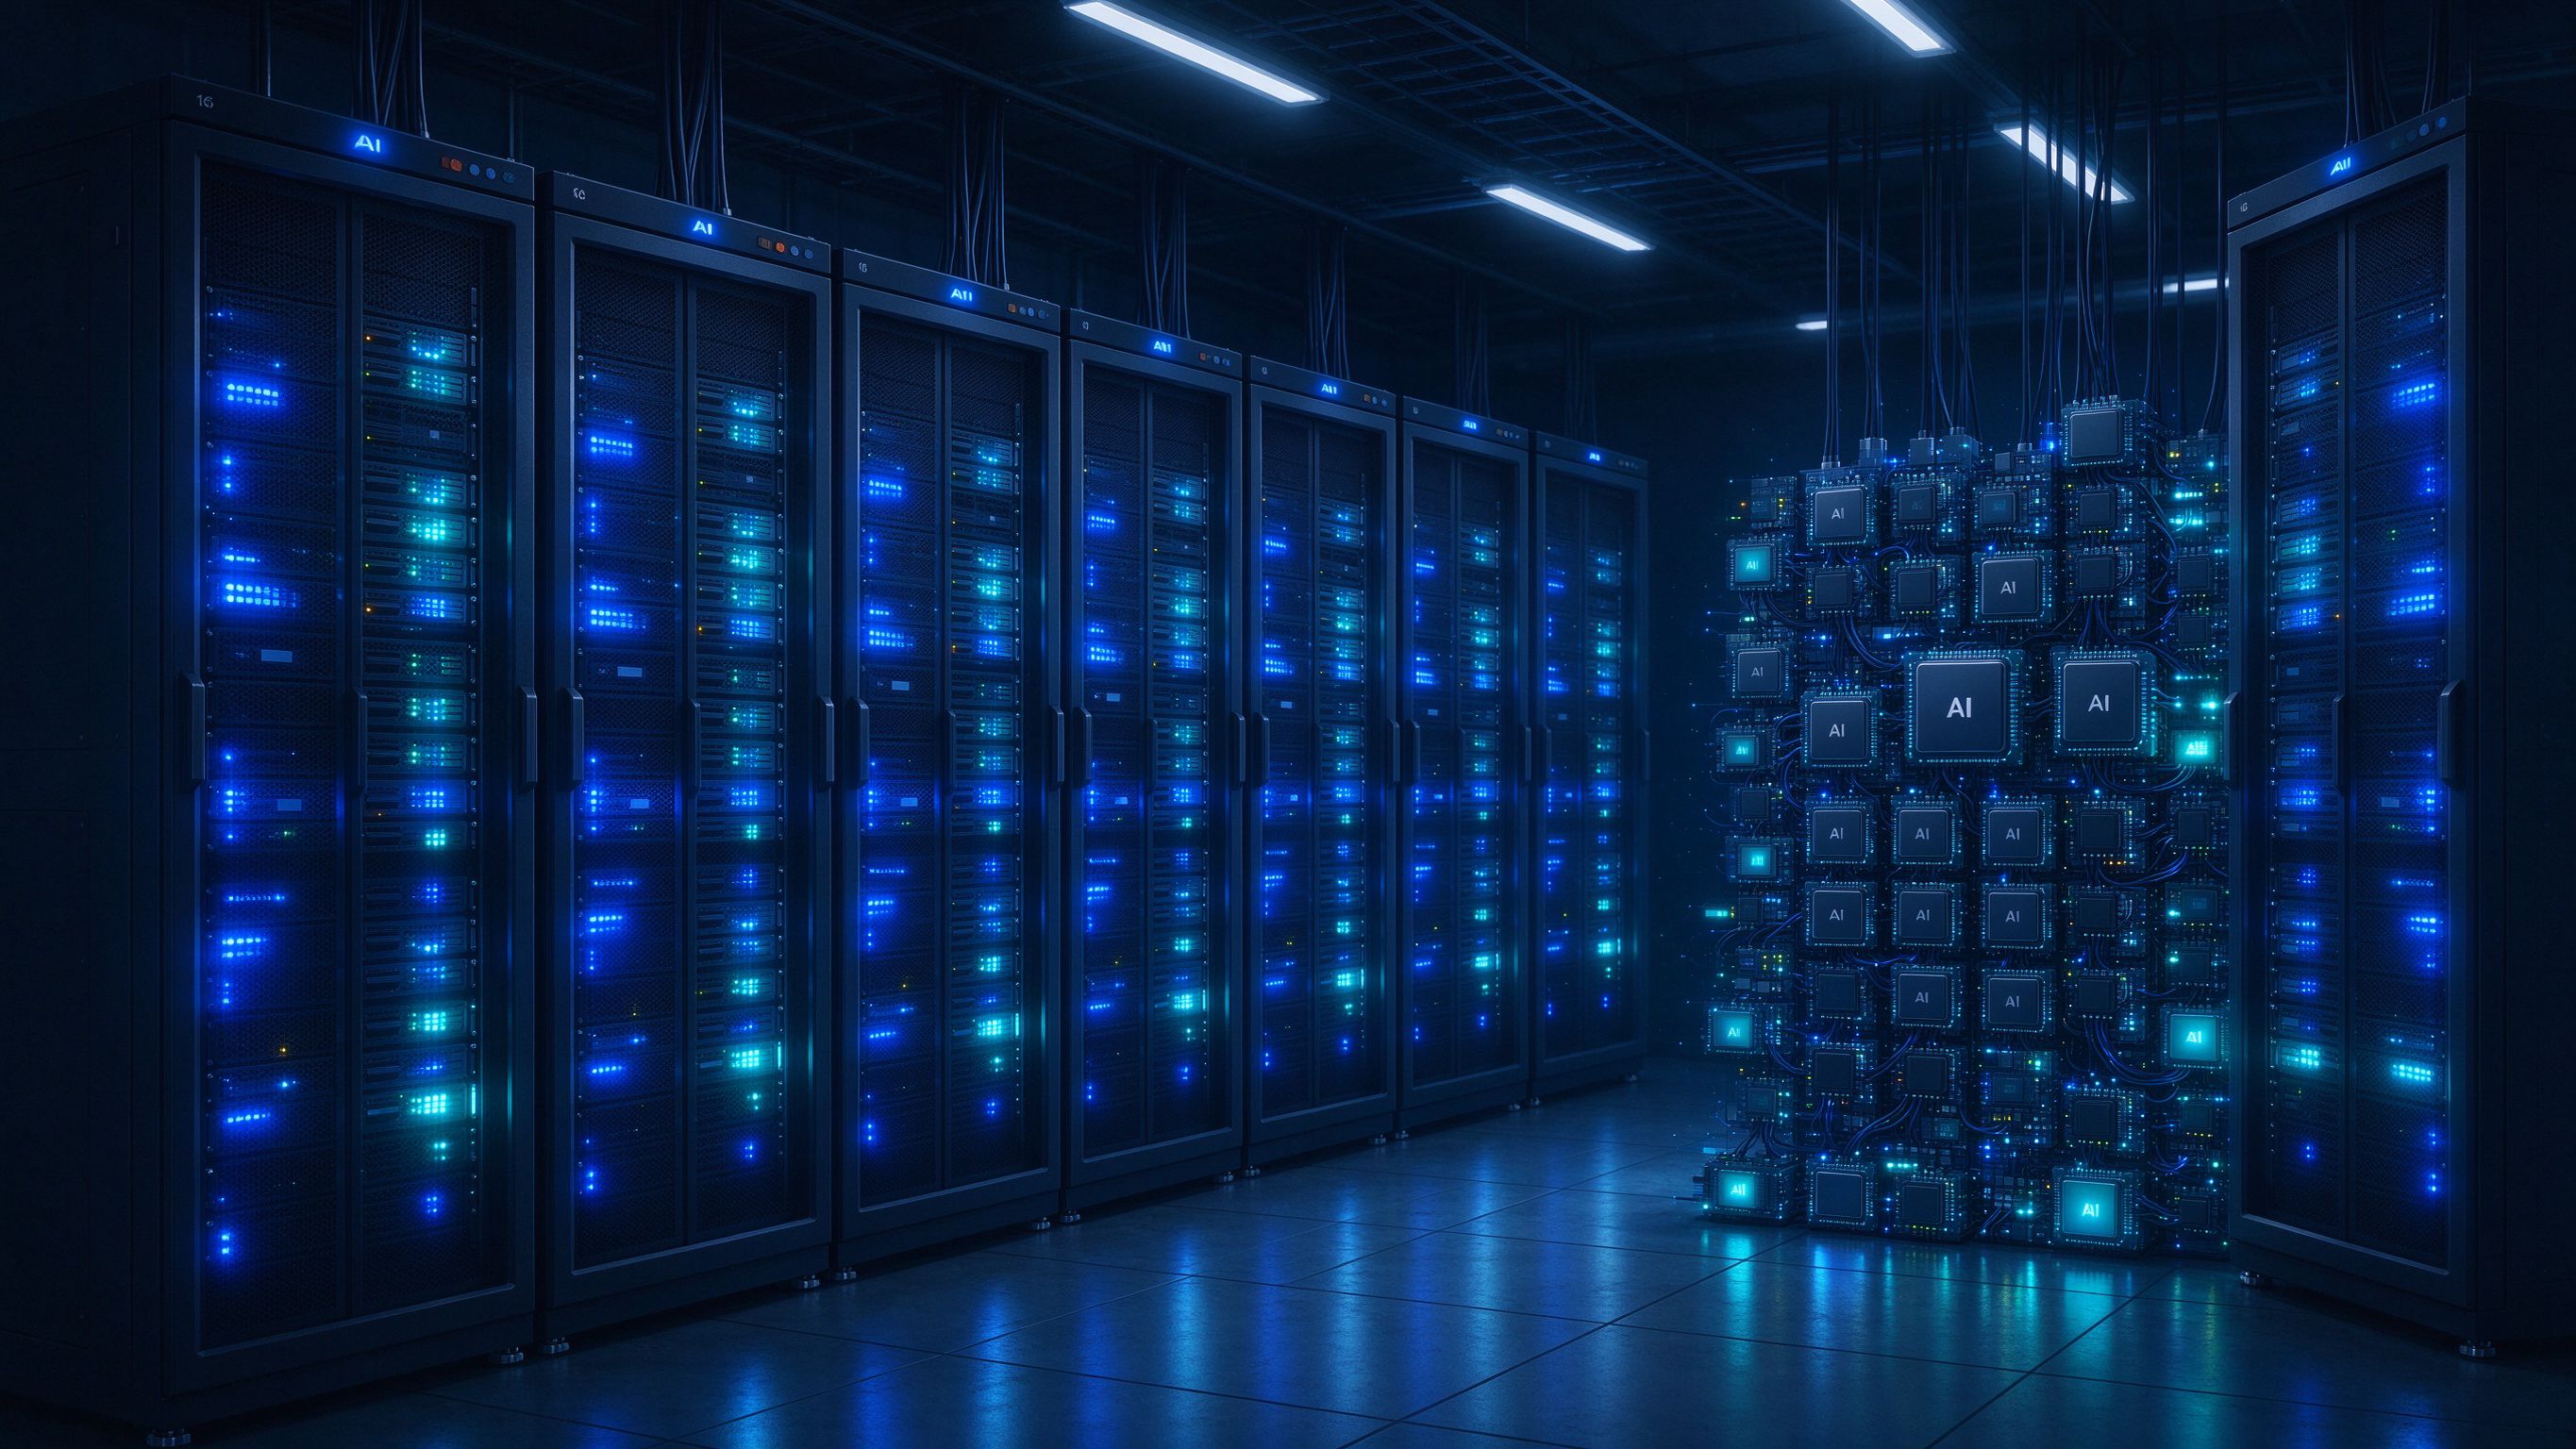
一、800 亿晶体管堆出的算力怪兽
H100 最直观的数字是晶体管数量:800 亿,比上一代 A100 翻了近一倍。这么多晶体管堆进去,换来的是相对 A100 数倍于前的 AI 训练和推理性能。它采用台积电 4nm 工艺,搭载新一代的 NVLink 高速互连,把多颗 H100 连成一个巨大的计算池。NVIDIA 甚至展示了由数万颗 H100 组成的 DGX SuperPOD,号称能提供每秒 exaflops 级别的 AI 算力。
这种规格已经远远超出了普通消费者的想象空间。H100 不卖个人电脑,它的归宿是云厂商的机房、AI 公司的训练集群。一颗 H100 的价格动辄数万美元,一个训练集群动辄就要几十亿人民币。它是 AI 这场军备竞赛里最核心的重型武器。
二、专为 Transformer 而生的那个引擎
真正让 H100 与众不同的,是那颗 Transformer Engine。过去几年,大语言模型和视觉模型几乎都建立在 Transformer 这一种架构之上。H100 在硬件层面加入了对一种新的浮点格式的原生支持,可以在训练时动态调整精度,既保证模型收敛的稳定,又大幅提升计算吞吐。
这意味着什么?意味着同样一批 H100,跑 Transformer 模型时的效率,比跑传统模型高出一大截。黄仁勋给出的演示数字是,相比 A100,H100 在大语言模型训练上能带来数倍的性能提升。这种为单一架构量身定制的思路,在通用 GPU 的历史上并不多见。它说明,AI 已经重要到足以反过来定义芯片设计的程度。
三、AI 工厂这个说法,到底什么意思
黄仁勋把数据中心称作 AI 工厂,其实是在打一个很贴切的比方。传统工厂用机器把原材料加工成商品,而 AI 工厂用海量算力把数据加工成智能——模型权重、推理结果、推荐策略。H100 就是这座工厂里最新一代的机床。
沿着这个比喻往下想,就能理解为什么云厂商在 2022 年集体疯狂采购 GPU。大模型的竞争,本质上是算力的竞争。谁能调动更多更快的 H100,谁就能训练出更大更强的模型。这也是为什么 NVIDIA 的股价在过去一年一路狂奔——它卖的不是芯片,是这场竞赛的入场券。
四、对整个 AI 产业链的拉动
H100 的发布,带动的是一整条产业链。光模块需要把几万颗 GPU 高速连起来,对带宽和延迟的要求极高;散热需要全新的液冷方案,否则这么多芯片一起发热根本压不住;供电、机柜、网络交换机,全都要跟着升级。一颗旗舰 GPU 背后,是整个数据中心基建的换代。
对国内的 AI 公司,H100 既是向往也是焦虑。向往的是它代表的顶尖算力,焦虑的是,最先进的算力能不能顺畅买到、能不能持续买到。这种对算力自主可控的紧迫感,在 2022 年正在一点点变成现实压力。
五、写在最后
站在 2022 年春天看,H100 更像是一个时代的注脚。它标志着芯片行业的重心,正在从通用计算加速转向 AI 专用计算。未来几年,谁掌握了最先进的 AI 芯片,谁就握住了通往智能时代的钥匙。这场算力竞赛,才刚刚鸣枪。
六、普通开发者能从中读到什么
如果你不是云厂商的采购,也不训练百亿参数模型,H100 这颗芯片听起来和你八竿子打不着。但它其实在悄悄影响你每天用的那些应用。你在手机里用的语音识别、翻译、推荐、拍照抠图,背后越来越多地是跑在这类加速卡上的大模型。H100 越强,这些模型迭代越快,你能用到的功能也就越聪明、越便宜。
对做算法和平台的工程师,H100 的意义在于,它重新定义了什么叫合理的模型规模。过去受限于算力,很多想法只能停留在论文里;现在单集群的算力往上跳了一个数量级,那些曾经想都不敢想的大模型实验,第一次有了落地的可能。这种算力红利,最终会以新产品的形式,一层层传递到普通用户面前。
还有一个容易被忽略的点:H100 把 AI 计算的门槛越抬越高。当训练一次前沿模型需要上万颗高端 GPU、烧掉几千万美元,这个游戏就不再是小团队玩得起的了。算力的集中,正在让 AI 研究的话语权,越来越向少数几家手里握着海量芯片的公司聚拢。这种格局对行业是好是坏,现在还说不清。
但无论如何,H100 都是 2022 年算力版图上绕不开的一块。它提醒我们:这场由大模型点燃的竞赛,比拼到最后,拼的从来不是算法灵光一现,而是谁手里有足够多、足够强的计算资源。算法是矛,算力就是盾,两者缺一不可。而在这场漫长的军备竞赛里,今天这颗 H100,注定只是众多里程碑中的第一块。往后看,更大的集群、更强的芯片、更便宜的算力,会一浪接一浪地涌来,推着整个 AI 行业不断往前。
七、从训练到推理,算力都在涨价
值得补充的是,H100 的野心不止于训练,它在推理上同样下了大功夫。过去大家关注大模型,眼睛都盯着训练环节,觉得那才是烧钱的大头;但真正把模型做出来之后,海量的日常调用——也就是推理——才是长期持续、规模更大的开销。一次问答背后,都是真金白银的算力在跑。H100 在推理吞吐上的优化,瞄准的正是这块越来越大的蛋糕。
这也解释了为什么云厂商愿意花大价钱囤 GPU。模型一旦做出来,要靠它对外提供服务、赚钱,推理成本就是决定一门生意能不能成立的关键。谁的推理效率更高、每一次调用更便宜,谁就能在这场 AI 商业化的竞赛里跑得更久。H100 把训练和推理两端一起拿捏,自然成了抢手货。
回过头看,2022 年这个春天,与其说是在发布一颗新芯片,不如说是在宣告一个新时代:算力正式成为像石油一样被争夺的战略资源。围绕它的采购、运输、管制、自建,会在接下来几年反复登上新闻。今天发布会上的一颗芯片,不过是这场大戏的开场。
对我们这些围观者,最好的姿态是看懂这股浪潮往哪走。算力在升值,AI 在提速,今天看似遥远的一场发布,明年就可能变成你手机里那个更好用的新功能。看懂算力的流向,就是看懂这个行业的未来。
当一颗芯片开始为一种模型架构量身定制,我们就知道:AI 已经不再是软件的故事,它正在重写整个硬件世界的版图。

0 条评论
还没有评论,快来抢沙发吧!
发表评论