4 月 25 日,华为云在线上发布了盘古系列超大规模预训练模型。消息在国内 AI 圈激起不小的涟漪——这是国内第一批真正在参数规模上叫板 GPT-3 的中文大模型。作为长期跟踪大模型和云计算的从业者,我觉得有必要冷静拆解一下:华为盘古到底做到了什么,它对国内 AI 意味着什么,又有哪些地方还不能高兴得太早。大模型这两年热得很快,越是这样,越需要有人把喧嚣背后的技术逻辑和商业现实讲清楚,让从业者既看到机会,也看清边界。
一、盘古到底有多大
这次发布的核心是两个大模型。一个是盘古 NLP 大模型,由华为云联合循环智能、鹏城实验室开发,是当时业界参数规模最大的中文语言预训练模型之一,预训练阶段学习了约 40TB 的中文文本数据,并在中文语言理解评测 CLUE 上刷新了多项榜单纪录。另一个是盘古 CV 大模型,视觉预训练参数达到三十亿,号称是当时业界最大的视觉模型。相比 NLP 偏向文字理解,CV 大模型瞄准的是图像识别、目标检测这类视觉任务,目标是让机器“看得懂”世界的通用能力,而不是只认得某一类物体。
技术上最值得关注的,是它的训练方式。盘古大模型基于华为自己的昇腾 AI 处理器集群和 MindSpore 框架训练,通过自动并行计算把训练任务扩展到数千张加速卡上。这背后的意义不只是“又一个大模型”,而是国产算力加国产框架,第一次在千亿级参数规模上跑通了完整链路。对长期被海外 GPU 生态绑定的国内 AI 行业来说,这是一次重要的自主验证。
要知道,训练这种规模的模型,难点从来不只是买卡。它需要把成千上万张加速卡高效地协同起来,解决通信、容错、显存调度、并行策略等一整套工程问题。华为能把这套流程跑通,靠的是多年在云计算和 AI 基础设施上的积累。这也解释了为什么大模型竞赛看似是算法之争,背后拼的其实是系统工程能力和长期的基础设施投入。
二、为什么是“预训练大模型”这条路线
过去做 AI,习惯的是“一个任务训一个模型”:要做分类就标分类数据,要做识别就标识别数据,模型之间互不相通。而预训练大模型走的是另一条路——先用海量无标注文本把通用能力训出来,再针对具体行业做少量微调。这样一来,一个底座模型就能适配文本分类、问答、摘要、检索等大量任务,大幅降低 AI 落地的边际成本和试错门槛。
GPT-3 在英文世界已经证明了这条路线的潜力,而中文世界长期缺少一个对等的“底座”。华为盘古的出现,某种程度上补上了这个缺口。更关键的是,它不是停留在论文里,而是被放进了华为云的服务体系里,目标是做“工业化的 AI 开发”——让企业不用自己养一个庞大的算法团队,也能调用到大模型能力。
这件事的商业想象空间很大。过去一家中小企业想做智能客服、智能质检或文档摘要,往往要从零开始标注数据、训练模型,成本高、周期长。有了预训练大模型之后,这些任务可以变成“调用一个接口”的事。当 AI 的能力被云服务化、按需付费化,它的客户群体就会从头部大厂,一下子扩大到成千上万的中小公司。这也是云厂商竞相押注大模型的根本原因。
三、冷静看:从榜单到落地还有距离
热闹之余,有几个问题必须摊开。第一,参数大不等于效果好,更不等于好用。大模型在通用文本上表现惊艳,但一到专业、严谨、对错误零容忍的场景,就容易出现“一本正经地胡说”。如何保证输出的可靠性和可控性,是所有大模型共同的难题,也是行业必须共同面对的长期课题。
第二,中文预训练数据的质量和多样性,直接决定了模型的上限。40TB 听起来很大,但高质量、多领域、少噪声的中文语料,其实比英文稀缺得多。模型要真正深入行业,还需要大量垂直领域数据做调优,这恰恰是慢功夫。第三,推理成本。千亿参数模型的调用和部署都很贵,如何把它做得既聪明又便宜,是商业化能否走通的关键。
还有一个容易被舆论忽略的现实:大模型不是万能钥匙。它擅长生成、归纳、联想,但在需要精确计算、严格逻辑和事实核查的任务上,依然会出错。未来真正可靠的系统,大概率不是“一个大模型包打天下”,而是大模型与传统规则引擎、检索系统、行业知识库相互配合的组合。理解这一点,就不会对大模型抱有不切实际的期待,也才能把它用在真正能发挥价值的地方。
四、对国内 AI 产业的信号
抛开具体数字,我认为这次发布最大的价值,是给国内 AI 产业打了一剂强心针。它证明了两件事:一是中文完全可以训练出自己的大规模预训练模型,不必一味跟随英文路线;二是国产算力栈在大模型这个最吃资源的赛道上,具备了实战能力。
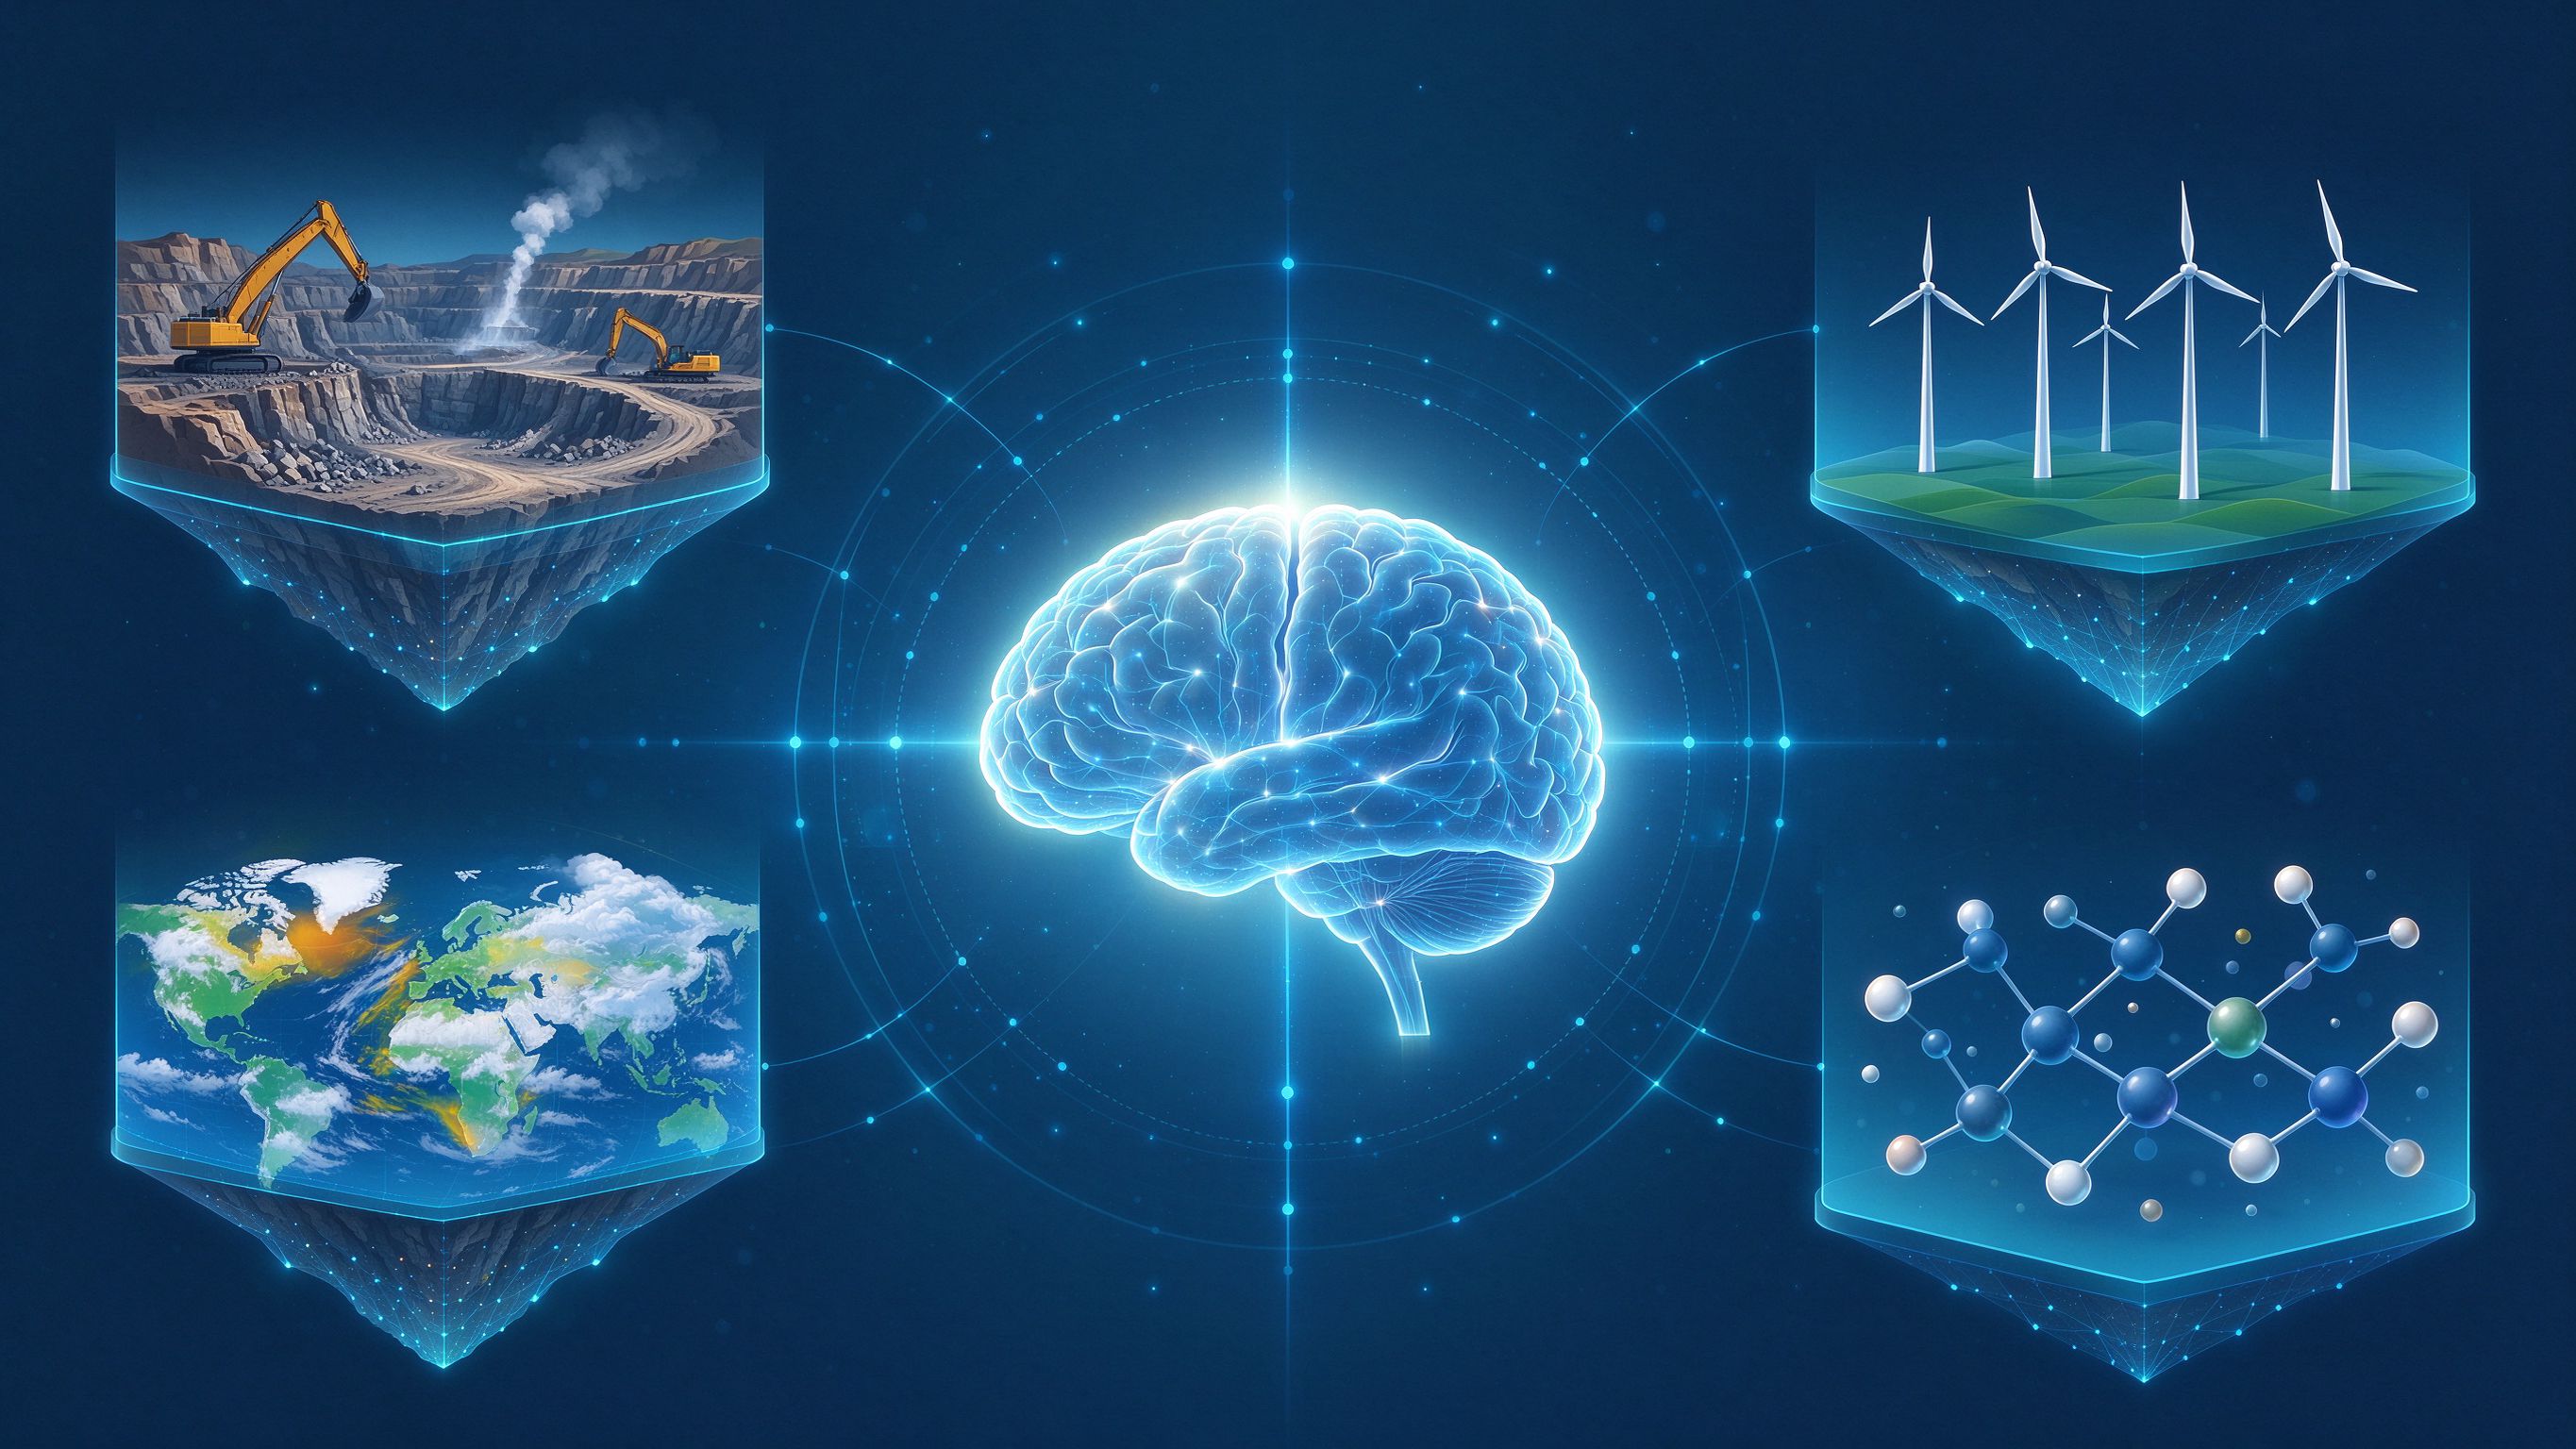
接下来更值得看的,是盘古如何走向行业应用。大模型的终局不是排行榜上的名次,而是能不能真正降本增效。矿山、气象、电力、药物分子这些垂直领域,才是检验它价值的考场。对国内从业者,我的建议是:与其迷信参数规模,不如沉下心研究如何把大模型和真实业务结合——让模型听懂行业的话,解决行业的问题,这比单纯堆参数更有意义。
从更宏观的视角看,大模型正在成为数字时代的“新水电煤”。谁掌握了好用、便宜、可控的大模型能力,谁就能在各行各业的数字化浪潮里占据枢纽位置。华为盘古的意义,不只是一款产品,更是一次产业卡位:它试图把算力、框架、模型和行业场景串成一条完整的自主链条。这条链条能不能真正转起来,还需要时间验证,但方向已经清晰。对普通开发者来说,这也是一个值得提前关注的信号:未来的 AI 应用开发,很可能不再是“自己从零训练模型”,而是“站在大模型肩膀上做场景创新”。谁能更早熟悉这种新范式,谁就能在下一波应用浪潮里占得先机,真正把技术红利转化为产品竞争力。
盘古开天,意在辟地。国产大模型迈出的这一步,证明了我们既做得出模型,也搭得起算力。但真正的考验,不在发布当天的掌声里,而在日复一日的行业落地中,在每一个被真正解决的具体问题里。

0 条评论
还没有评论,快来抢沙发吧!
发表评论