2024年5月7日,深度求索发布了DeepSeek-V2。它没有像很多新模型那样把”参数更大”挂在嘴边,而是换了个角度:总参数做到2360亿,但每个token只激活其中一小部分(约210亿),再配上激进的定价。这背后指向的,是大模型行业一个越来越现实的命题——推理太贵,必须想办法把账单打下来。它一经发布,就在技术圈引发了不少关于”架构创新”和”价格屠夫”的讨论,也让更多人第一次认真去想:大模型到底该怎么把成本这件事,从根上解决掉。
MoE:为什么不把所有参数都用上
传统的大模型是”稠密”的:不管你问什么,模型里的每一个参数都要参与计算。模型越大,每次推理要烧的算力就越多,成本自然水涨船高。
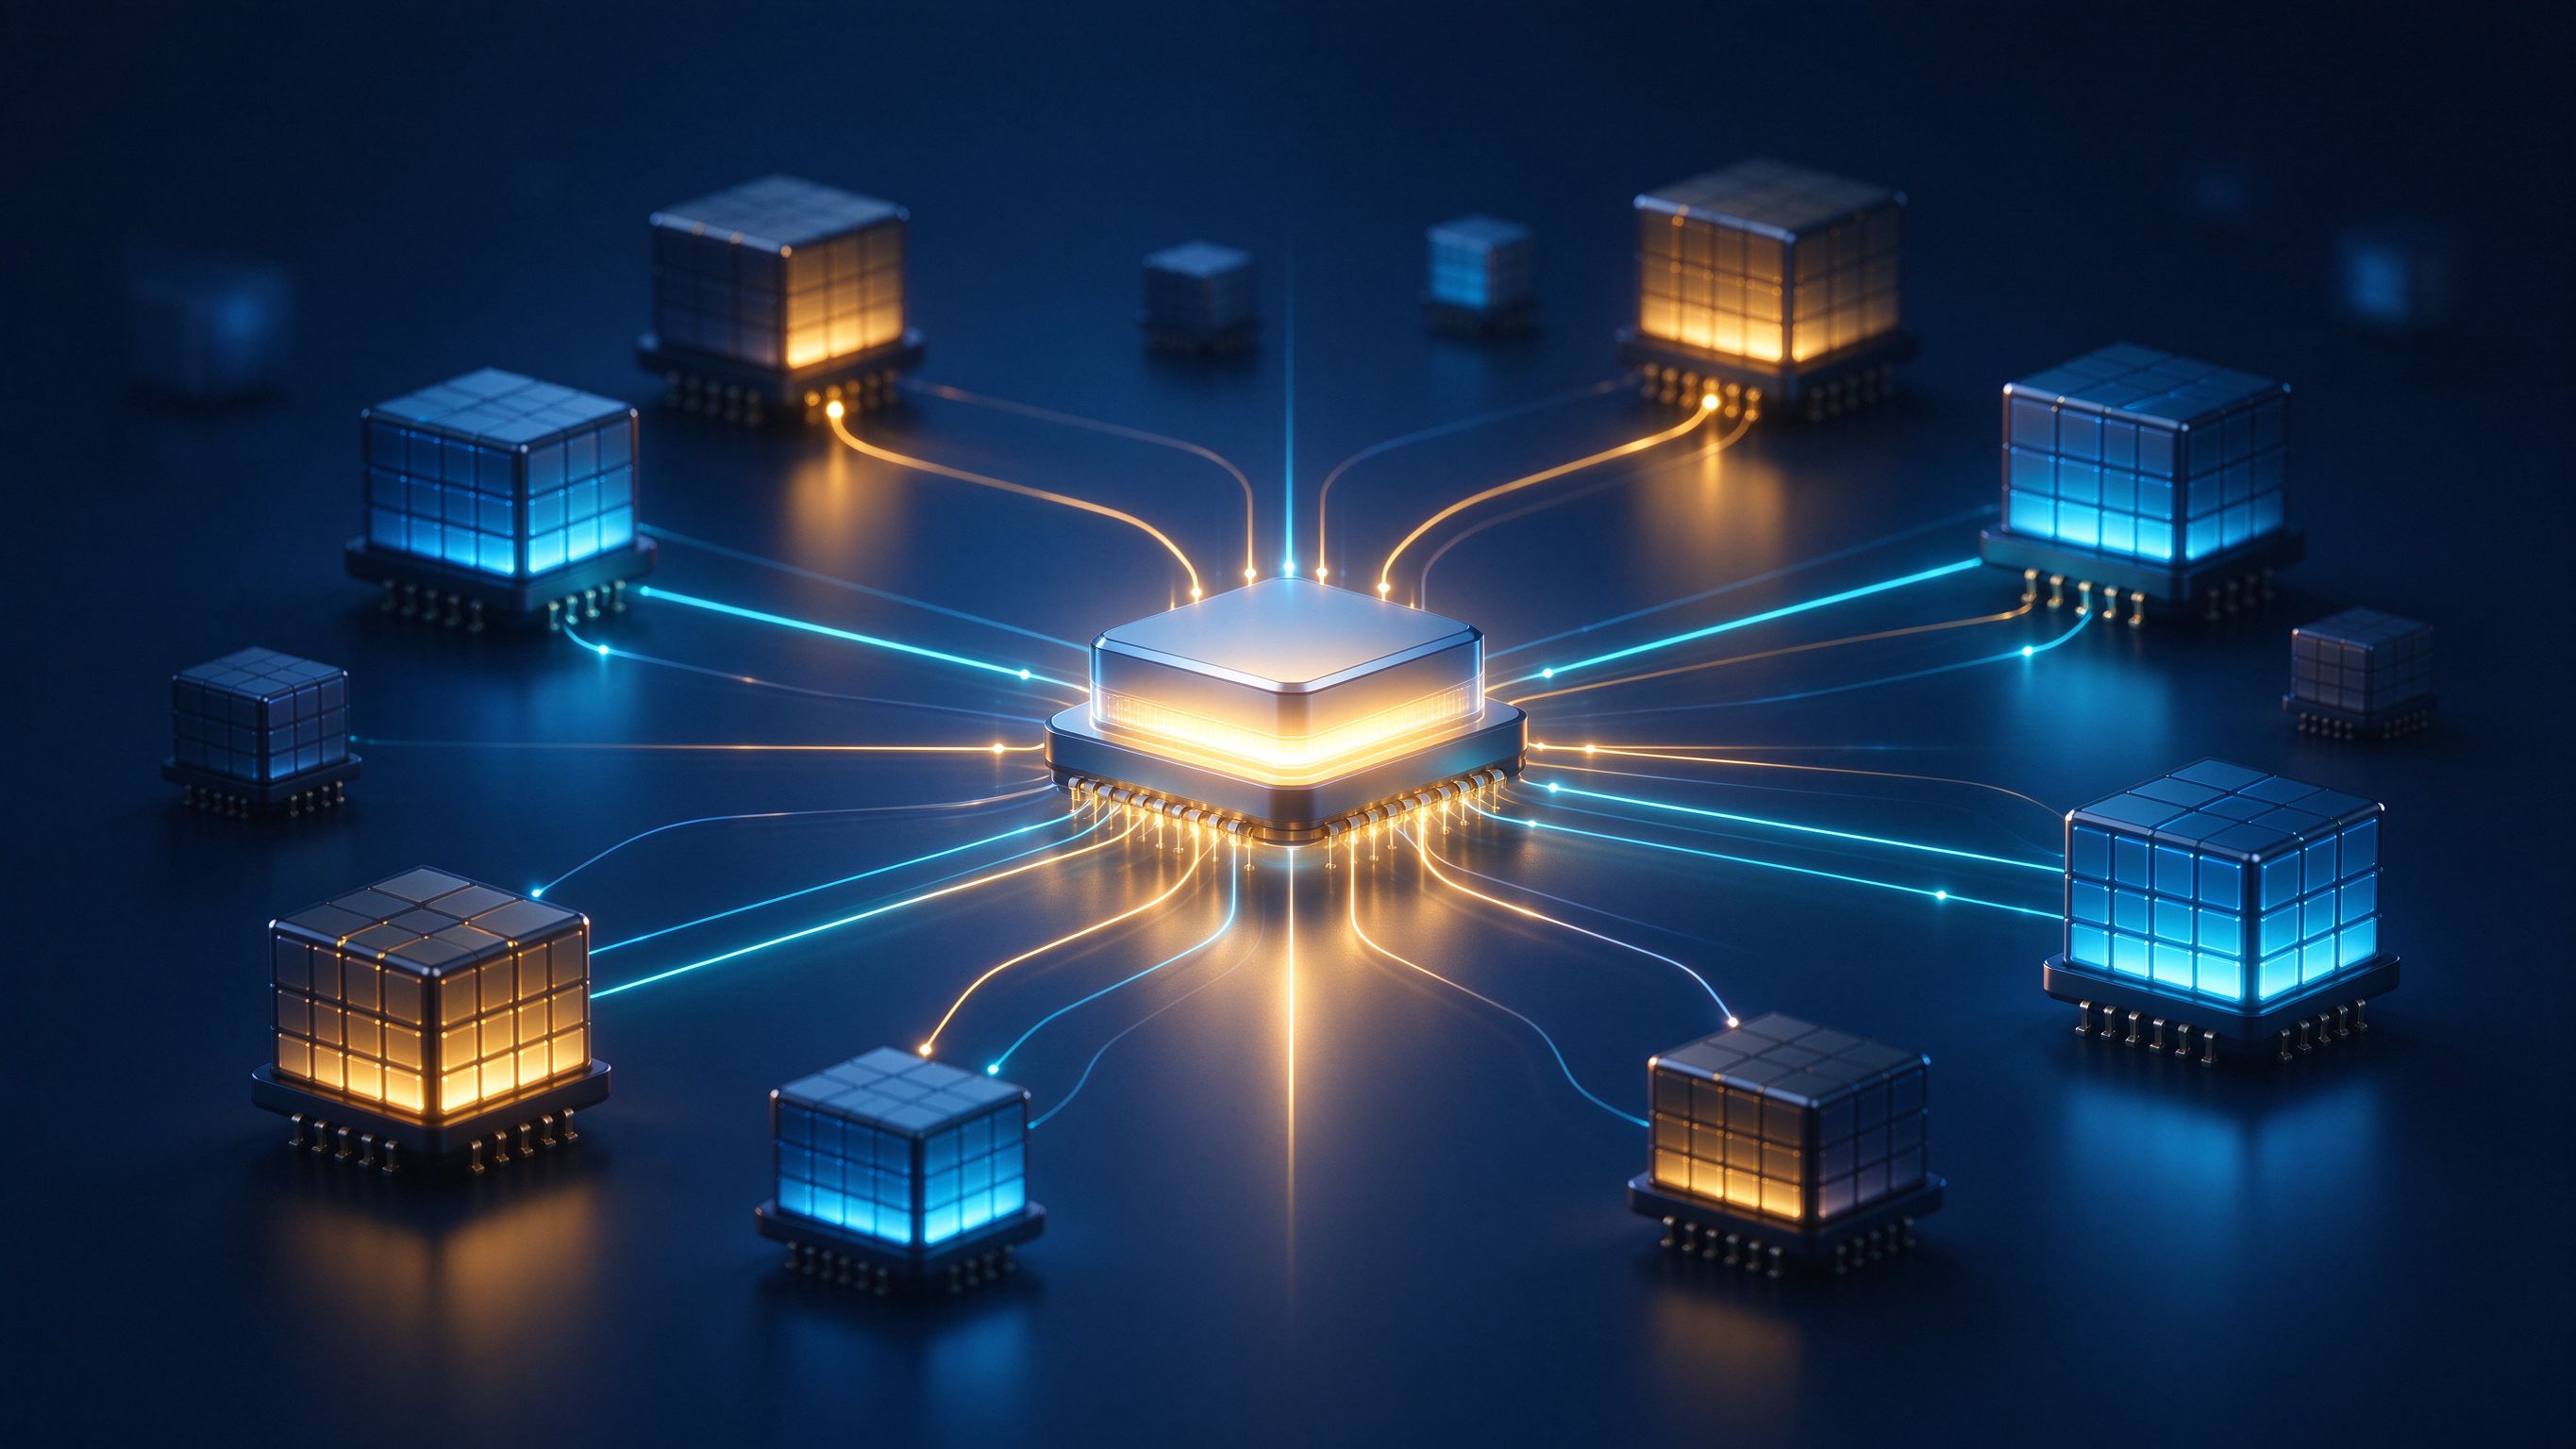
混合专家(MoE)换了个思路:把模型拆成许多个”专家”子网络,每次只根据输入,挑选最相关的少数几个专家来处理。这样一来,总参数可以做得很大、知识储备很足,但单次推理实际动用的算力却保持在较低水平。DeepSeek-V2正是用这种方式,在2360亿的总规模下,把单次激活压到了两百亿量级,相当于”大模型的脑子,小模型的开销”。
打个比方:稠密模型像一个全科医生,不管你看什么病,他都把全部知识调动一遍;MoE则像一家大医院,挂号分诊后,只把你送到对口的科室。医院的整体规模可以很大,但你这一次就诊,只占用了其中一个科室的资源。模型越大、专业分得越细,这种”按需调用”省下的算力就越可观。
这对”用得起AI”意味着什么
要理解这件事的分量,得先明白大模型的钱都花在哪。训练一个超大模型,是一次性的巨额投入;但真正每天都在烧钱的,是推理——每一次用户提问,都要调用一遍模型。当一个AI应用从”尝鲜”走向”日活百万”,推理账单会指数级上涨,很多团队就是被这笔钱拖垮的。
对开发者和企业,最直接的感受就是便宜。推理成本下降,意味着那些过去因为”太贵”而不敢规模化的场景——比如海量客服、批量文档处理、实时内容生成——突然变得划算起来。
当一个能力足够强的模型,推理成本只有同类稠密模型的一个零头,产品设计的天花板就被抬高了。你不必再为了省钱而把用户请求小心翼翼地合并、缓存,很多原本”算不过账”的AI功能,第一次有了商业可行性。
这种变化对创业公司尤其友好。过去,大模型的高门槛让小团队只能望洋兴叹;如今,便宜又开放的基座,让几个人的小团队也能快速搭出一个像样的AI产品,把精力省下来用在真正的差异化上,而不是和算力账单搏斗。
开源权重:把主动权交还给用户
DeepSeek-V2走的是开放权重路线。所谓开放权重,简单说就是把训练好的模型参数公开,任何人都可以下载、部署、修改,而不必只能通过官方API隔着一层使用。这意味着企业可以把它部署在自己的基础设施上,数据不出内网,再按自己的业务做微调。对金融、政企这类对数据合规极度敏感的行业,这种”我能自己掌控”的价值,往往比单纯的价格更重要。
开放权重还降低了研究门槛。高校和小团队不必再花费巨资训练模型,就能站在一个强模型的肩膀上做实验。整个生态因此被盘活——好的基座会吸引来更多工具、教程和衍生模型,形成正向循环。
这也给云基础设施出了道新题。MoE模型体积大、需要同时把多个专家载入显存,对GPU的显存容量和调度能力提出了更高要求。谁能把这种大模型高效地跑起来、管好、再以合理价格提供出去,谁就能在这波AI基建潮里占住位置。模型架构的每一次变化,都会顺着链条传导到算力和云服务的采购、部署与定价上,这也是为什么说”成本”从来不只是模型厂商自己的事。
冷静看待:不是没有代价
需要清醒的是,MoE并不是免费的午餐。它把成本从”单次推理”转移到了别处:更大的模型体积意味着更高的显存占用和更复杂的部署调度;专家路由是否精准,直接影响输出质量;而多出来的参数,也让训练和维护的难度上升。
换句话说,MoE省下的是推理账,但抬高了工程门槛。能不能把它的便宜真正落到自己的业务里,取决于团队有没有足够的算力工程能力去驾驭它。
还有一点:便宜不代表谁都能用好。开源权重到手,只是第一步;怎么部署稳定、怎么微调贴合业务、怎么在高并发下不崩盘,都是实打实的工程量。很多团队看着诱人的低价,最后却卡在”跑不起来”上,这是采用开源模型时最常见的落差。
写在最后
便宜,也是一种实实在在的竞争力,而且在不远的将来一定会越来越重要。
DeepSeek-V2代表的,是大模型行业从”比谁更聪明”走向”比谁更可持续”的一步。当能力逐渐趋同,谁能把成本压得更低、把效率做得更高,谁才可能把AI真正铺到千行百业。这场围绕成本的较量,才刚刚开始,也注定会贯穿于整个AI大规模落地的全部漫长的过程之中去。
对普通从业者,这其实是个好消息:技术不再只是实验室里的奢侈品,而是在通过架构和工程的改进,一步步变成人人用得起的水电煤。
理解这些藏在参数背后的成本账,比单纯追逐”谁的分数更高”,更能帮你看清这个行业真正往哪走、机会又究竟藏在哪里。

0 条评论
还没有评论,快来抢沙发吧!
发表评论