做了这么多大模型项目,我越来越坚信一句话:大模型应用的效果上限,往往不是被模型本身决定的,而是被你喂给它的数据决定的。很多人效果不好,第一反应是”换个更强的模型”,或者”再调调提示词”,却很少回头看看:你给它的那些资料,本身是不是干净、准确、靠谱。这篇文章,我想把”数据”这件经常被忽视的基本功,认真地讲一讲。
为什么数据是那个被忽视的瓶颈
大模型再聪明,它输出的质量也建立在你给它的输入之上。这就像做饭,食材不新鲜、乱七八糟,再好的大厨也做不出好菜。你把一份错漏百出、前后矛盾的文档丢给它去总结、去问答,它再努力,也只能基于这些烂材料给出一个流畅但错误的答案。而且更麻烦的是,它会把这些错误包装得特别自信,让你很难察觉。
很多团队的真实情况是:系统接了一大堆文档,格式乱七八糟、内容重复过时、还夹杂着明显的错误,却指望大模型能”自动处理好一切”。结果做出来的应用效果飘忽不定,排查半天,最后发现根子在数据上。这种事我在大大小小的项目里见过太多太多了。模型的能力这两年进步神速,反而是数据这个老问题,一直被低估。
你的数据可能藏着这些坑
具体来说,喂给大模型的数据,常见的坑有这么几类。第一类是”脏”:格式不统一、有乱码、有重复段落、有页眉页脚混进正文。这类问题看着小,但会直接干扰模型的理解。第二类是”错”:文档里本身就有过时的信息、相互矛盾的说法、或者干脆就是错的结论。模型不知道哪个是对的,只能照单全收。
第三类是”杂”:有用没用的资料混在一起,模型分不清主次。你以为给了它很多背景很贴心,实际上噪声太多,反而把它带偏了。第四类,也是最隐蔽的一类,是”陈旧”:你的业务一直在变,可知识库还是半年前的老黄历。模型基于过期数据回答,给出的当然是过时的结论。这四类坑,几乎每个项目里都能撞见。
该做的数据清洗,到底是什么
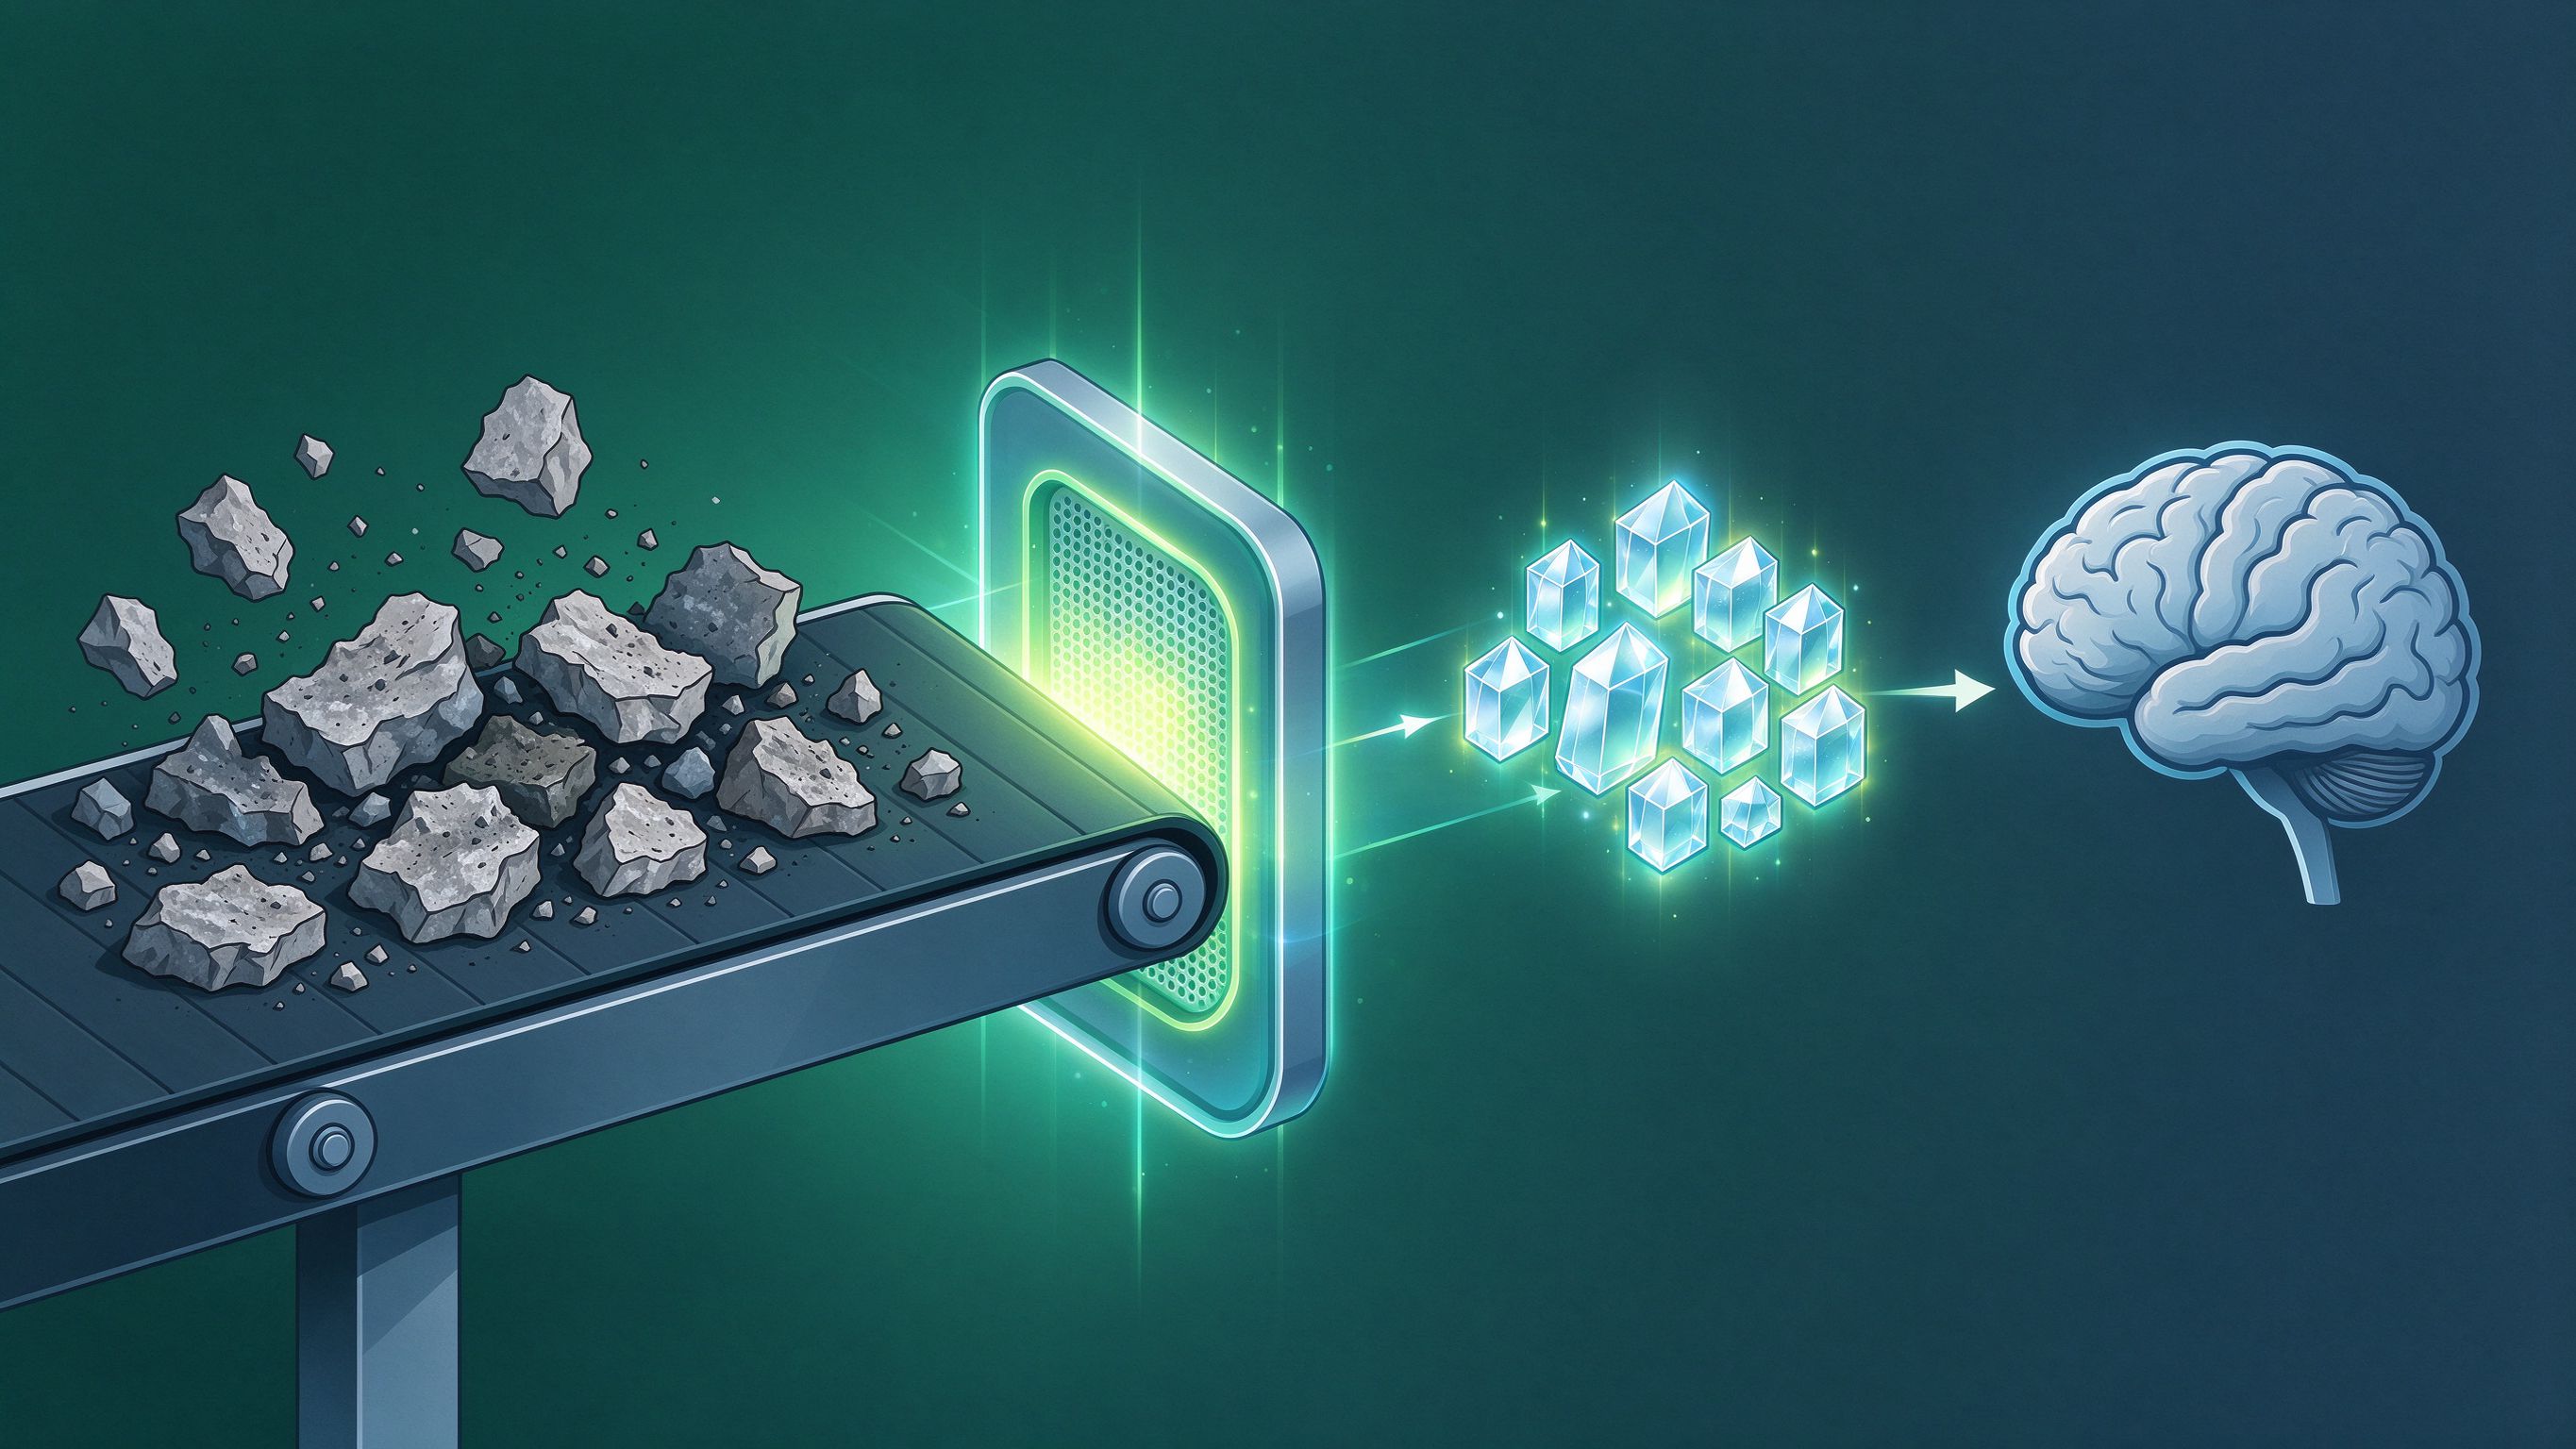
所谓数据清洗,不是说要把所有数据都人工重写一遍——那不现实。它的核心,是在数据进入大模型之前,做一轮系统的”打扫”。把明显的脏数据去掉、把重复的内容合并、把格式统一好、把过时的东西清理掉、把真正重要的资料挑出来。这一步做扎实了,往往比你在模型和提示词上折腾半天管用得多。
我自己的习惯是,先花功夫把数据这一关过好,再去谈模型选型和提示词调优。因为后者的边际收益,会被前者的质量死死压住。数据是浑的,你上面盖再漂亮的房子也是站不稳的。把这个顺序摆正——先数据、后模型——很多人调了半天调不出来的问题,可能一开始就迎刃而解了。
让数据”活”起来:更新机制
数据清洗不是一次性的活,而是要持续维护的。你的业务每天都在产生新内容、淘汰旧内容,如果知识库建好了就扔在那儿不管,它会一天天过时,效果也会随之下滑。所以从一开始就要想好:新内容怎么自动进来、旧内容怎么定期清理、怎么标记哪些资料是最新的。
这个”让数据活起来”的机制,决定了你的应用是越用越准,还是越用越废。我见过不少项目,上线时效果惊艳,半年后被用户投诉”答的都是老黄历”,根子就是没有更新机制。技术架构搭得再漂亮,数据是死水一潭,用户迟早会流失。
还有一个细节值得一提:数据的颗粒度。喂给模型的资料,切得太碎,会把一句话的上下文切断;切得太大,又会让无关内容混进来。这个切分的分寸,直接影响它能不能准确找到、准确理解你想要的那部分。很多人把文档整段整段丢进去,结果检索不准、答非所问,其实就是颗粒度没调好。这个看着不起眼的工程细节,往往就是拉开效果差距的地方。
别迷信模型,要敬畏数据
这两年行业里有一种风气,总在比谁家的模型更强。但作为天天做落地的人,我的体会恰恰相反:在大多数真实业务里,决定成败的不是模型之间那点细微的差距,而是你有没有把数据这个地基打牢。一个数据干净、机制清晰的普通模型,往往比一个数据混乱的顶级模型,给出的结果更靠谱。
一个真实的对比实验
说个我亲身经历的例子。我们帮一家企业做内部知识问答,一开始直接把他们服务器里堆了好几年的文档一股脑接了进去。结果效果很差,答非所问是常事,用户怨声载道。我们一度怀疑是模型不行,准备花钱升级。后来沉下心来查了一遍数据,才发现问题有多离谱:同一篇制度文件有七八个版本混在一起、文档里还夹着大量从网页复制时带进来的广告和导航栏、还有不少文件根本就是扫描件,文字全是乱的。
我们花了一周时间做数据清洗:去重、去广告、统一格式、只保留最新版本。就这一步,没换模型、没改提示词,问答准确率直接上了一个台阶,用户满意度完全变了样。这个对比让我印象深刻:之前我们在”模型”上纠结了那么久,真正的解药却一直在”数据”那里。这样的故事,几乎每个认真做过落地的人,都能讲出一两个。
数据责任:谁来为它的质量负责
数据这件事,还有个容易被忽略的组织问题:谁来为它的质量负责?技术团队往往只管把管道搭通,至于管道里流的是什么,没人专门盯。结果就是,数据质量成了一个”人人有责却人人无责”的模糊地带。
我的建议是,从一开始就明确:这批数据的 owner 是谁,多久检查一次,出了错找谁。把数据当成和代码一样需要维护、需要负责的资产,而不是一堆扔在那儿就不管的静态文件。很多数据问题之所以长期没人管,不是因为多难解决,而是因为压根没人觉得这是自己的事。把责任落实到人头,数据质量才有真正的保障。
所以,下次你的大模型应用效果不理想,先别急着换模型、改提示词。停下来问自己一句:我喂给它的数据,真的干净、准确、新鲜吗?把这个问题想透、把这件苦活做扎实,你会发现很多”模型不行”的错觉,其实都是”数据不行”。敬畏数据,是把大模型用好最朴素、也最容易被忽略的一条真理。

0 条评论
还没有评论,快来抢沙发吧!
发表评论